AIを活用した監視アラートの一次調査自動化
既存のアラート通知に、Claudeによる一次調査を追加。GitHub Actions上でAWSのログ・設定と関連コードを調べ、根拠と対応候補をSlackへ返す監視運用基盤を構築しました。
対象: Markshipが運用するAWS環境の監視・一次調査
担当範囲: 調査フローの設計、AIエージェントの実装、AWS・GitHub・Slack連携、権限設計、障害再現による検証、既存案件への組込み
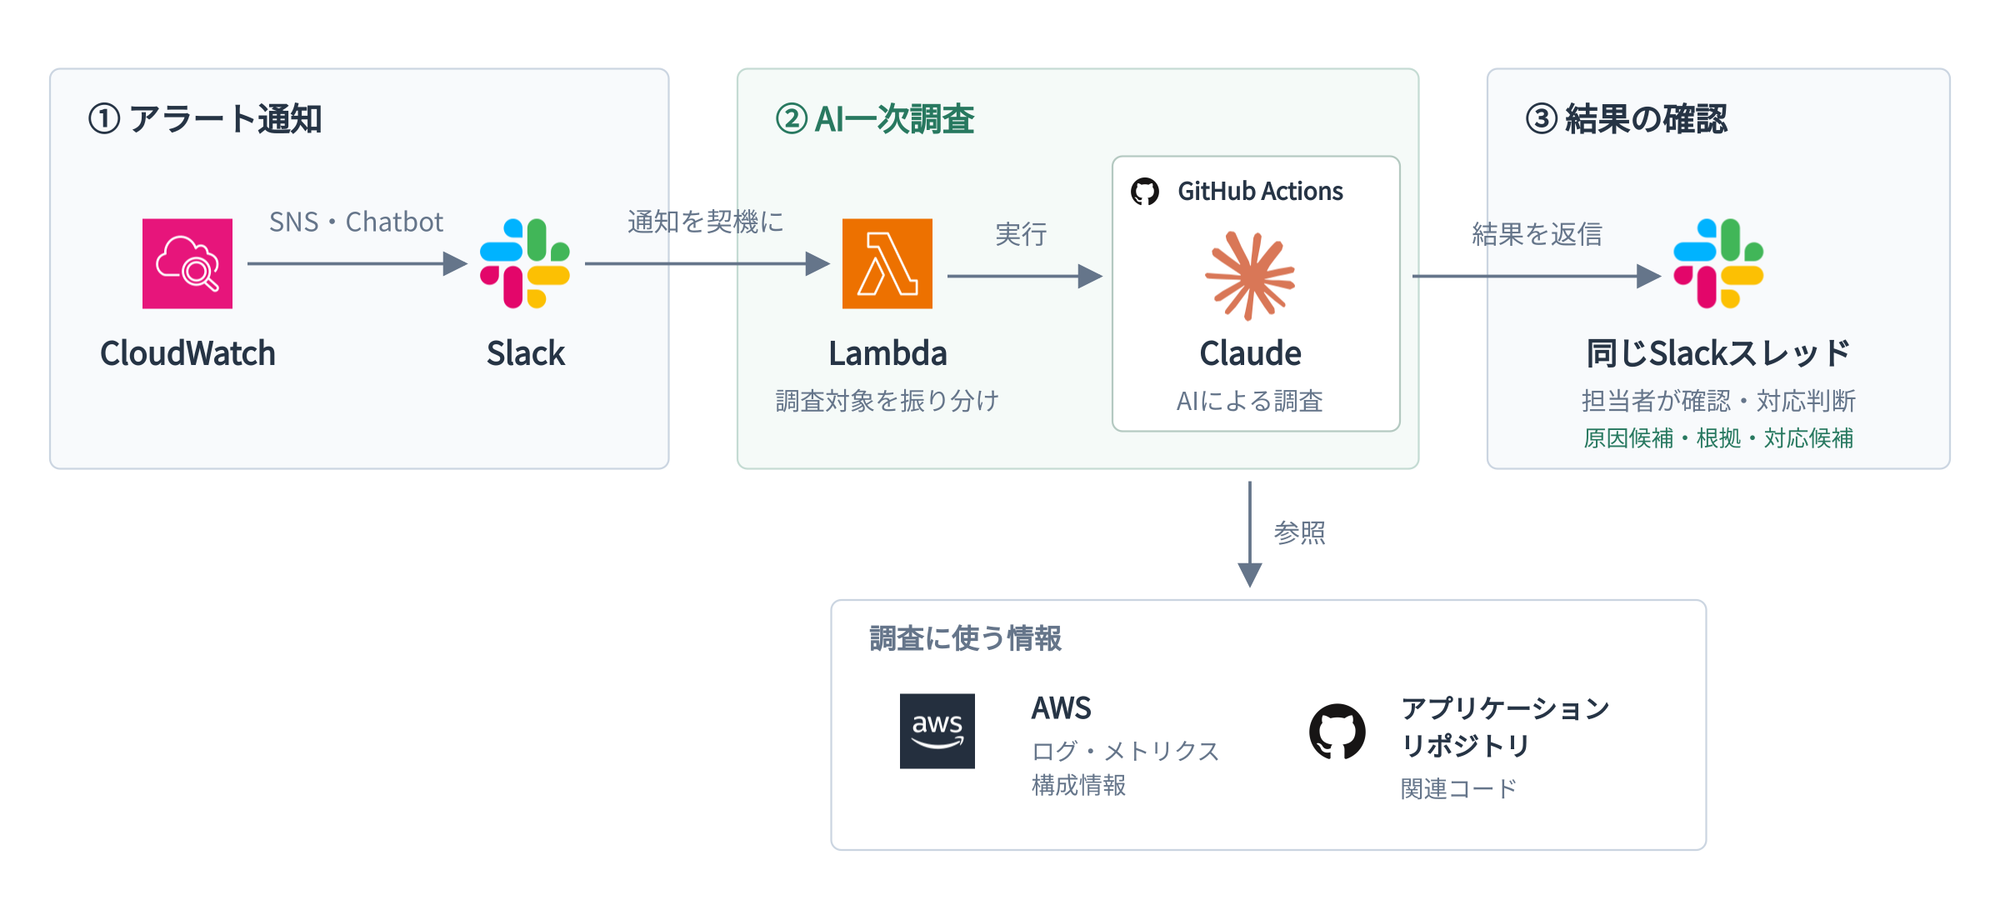
監視アラートの一次調査フロー。左右のSlackは同じ通知スレッドを表しています。
アラートの受信から、原因を調べるところまで
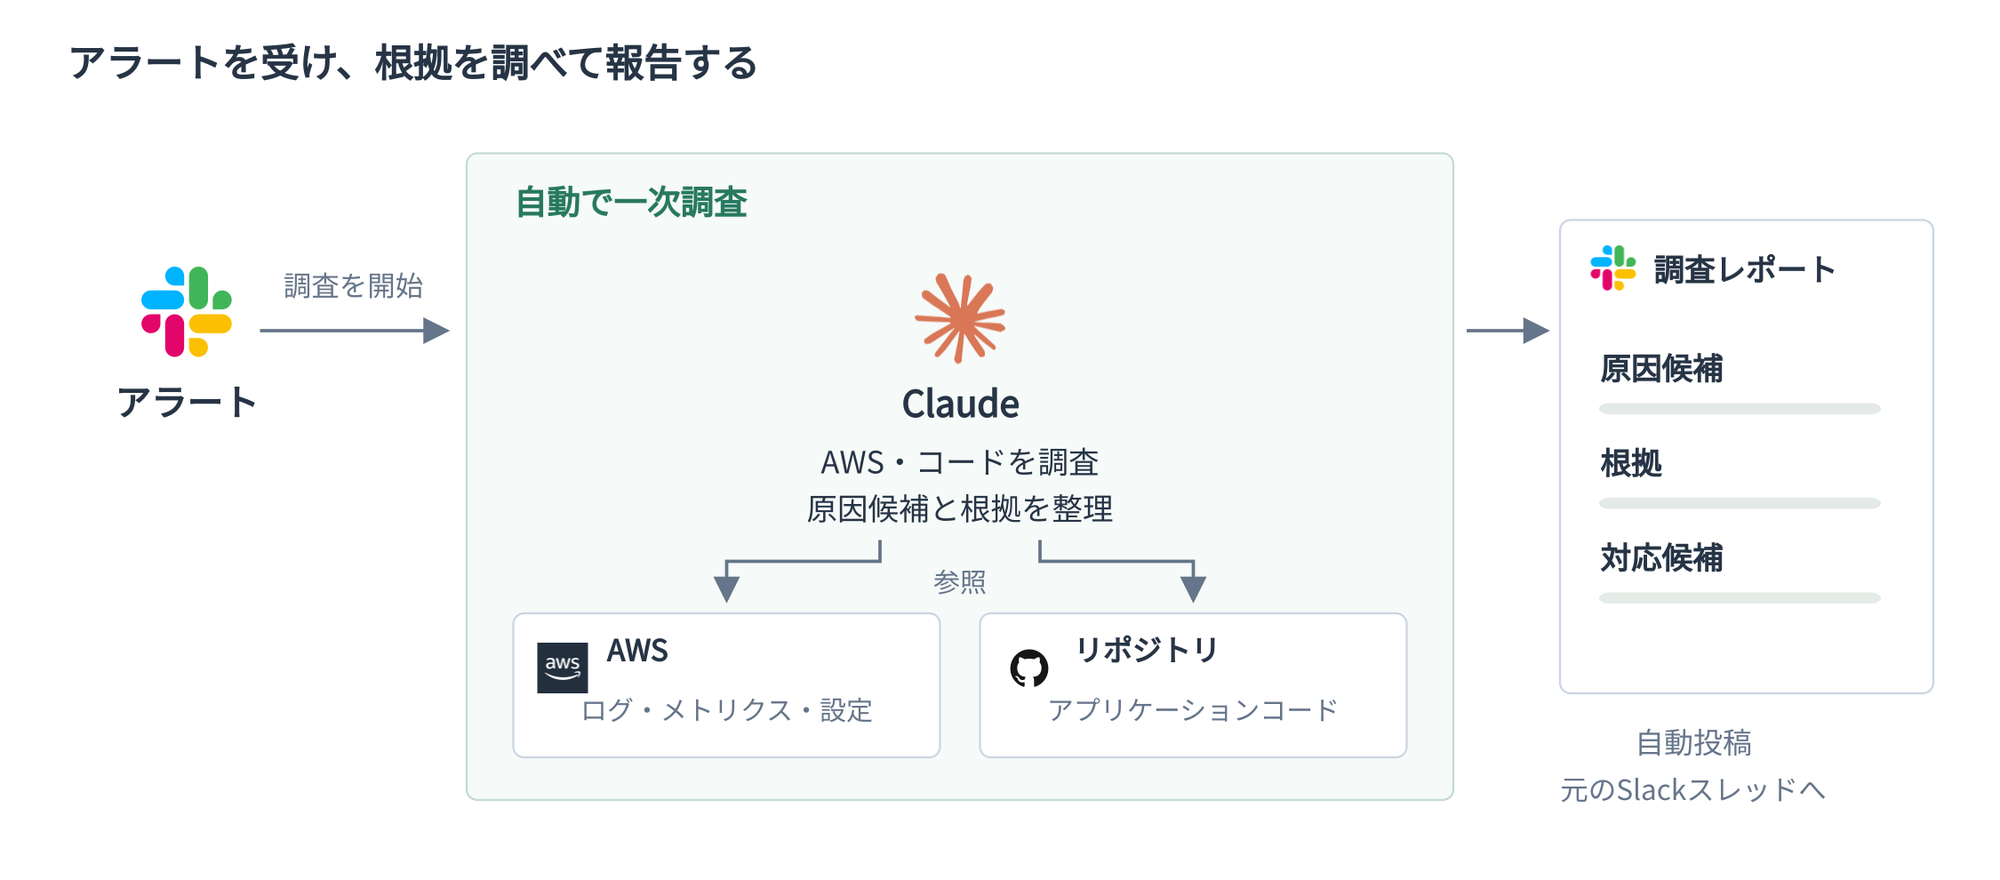
監視アラートが届いても、その通知だけで原因や対応方法を判断できるとは限りません。担当者はログやメトリクス、リソースの設定、アプリケーションコードを確認し、何が起きているかを整理する必要があります。
この初動を支援するため、既存の監視運用にAIによる一次調査を組み込みました。アラートを受けた後の情報収集と原因候補の整理を自動化し、担当者が根拠を確認して対応を判断できる構成にしています。
AWSの状態とコードを照らし合わせて調査
CloudWatchのアラートをSlackへ通知し、その通知を契機にLambdaが案件を判別してGitHub Actionsを起動します。GitHub Actions上では、AWSの情報収集からClaudeによる調査、結果の返信までを実行します。
まず、スクリプトがアラートに関係するログ・メトリクス・設定情報を収集します。Claude Agent SDKを使ったエージェントは、その情報と関連コードを確認し、必要に応じてAWSを追加で参照します。通知文だけで原因を推測するのではなく、実際の状態と処理内容を照らし合わせて調べる仕組みです。
Claudeが作成したレポートは、後続のスクリプトが元のSlackスレッドへ投稿します。担当者はアラートと一緒に、原因候補、その根拠、次に確認・対応することを確認できます。
構築時に重視したこと
通常の通知経路を保ったまま、AI調査を追加
既存のアラート通知とAI調査を分離するため、Slackに届いた通知を起点にしました。AIの応答を待ってから通知する構成ではなく、まず担当者へアラートを届け、その後に調査結果を追加します。AI調査が停止しても、通常の通知経路には影響しない設計です。
結果を同じスレッドに集約することで、担当者は通知と調査内容を一緒に確認できます。既存の確認場所を維持しながら、初動調査を補う方針としました。
調査対象を切り替え、同じ処理を複数案件で利用
案件ごとにAWSアカウントとGitHubリポジトリを指定し、アラートに応じて調査対象を切り替えます。情報収集・AI調査・結果返信の処理は共通化し、複数案件で利用できる構成にしました。
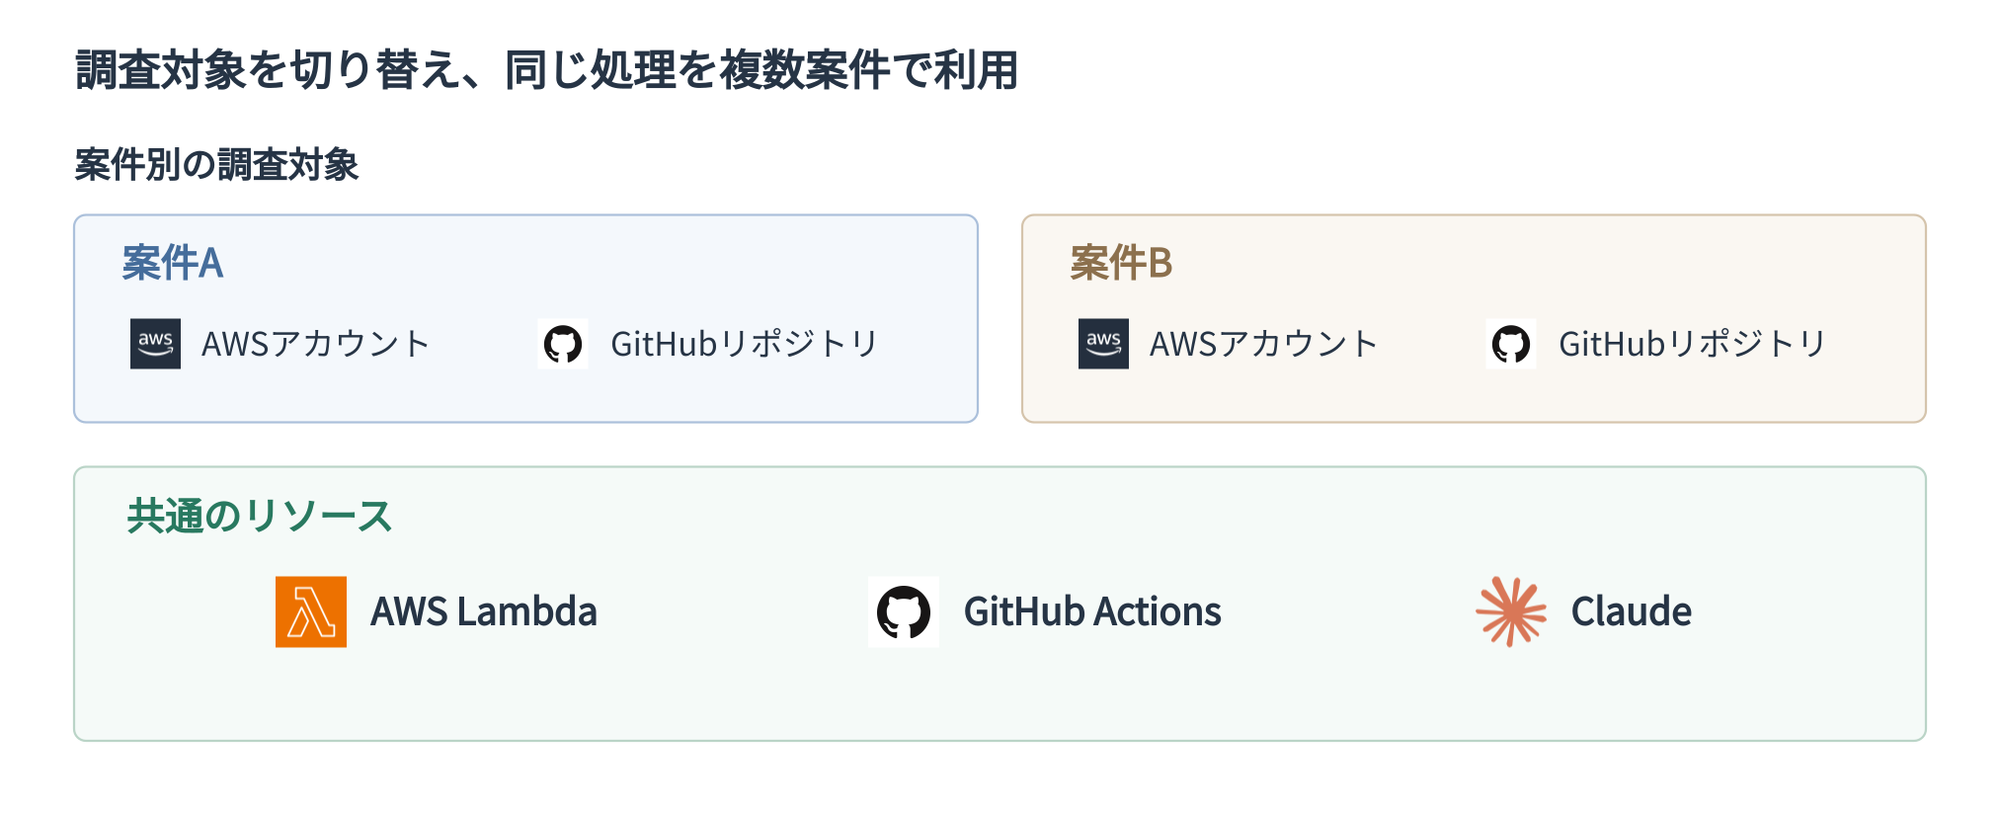
アラートを受け付けるLambdaとGitHub Actions上の調査・報告処理を共用します。対象案件のAWS参照ロールとリポジトリを使って調査し、結果は通知を受けたチャンネル・スレッドへ返します。
共通処理をGitHub Actionsのワークフローとコードで管理することで、調査方法の改善を案件ごとに作り直さず反映でき、変更履歴と実行結果もGitHub上で確認できます。
調査に必要な権限と情報を限定
対象のAWS環境へは、GitHub ActionsのOIDC認証を通じて参照用のIAMロールを引き受けます。AWSリソースを変更する権限は与えず、エージェントが実行できるコマンドも制限しました。
設定情報の収集時には秘密情報を除外・マスクし、関連コードの取得範囲や秘密情報を含むファイルの参照も制限しています。AIに渡す情報と実行できる操作の両方を絞る設計です。
根拠を示し、判断と対応は人に残す
調査結果では結論だけでなく、その根拠となるログや設定、コード上の箇所を示すようにしました。情報が不足する場合は原因を断定せず、追加で確認する内容を残します。
自動化の対象は情報収集と一次調査です。設定変更や復旧操作は、担当者が調査結果と影響範囲を確認したうえで判断・実行します。
障害を再現し、調査結果を検証
接続障害やCPU負荷、データベースの高負荷を再現し、原因の手がかりとなる情報を収集・報告できるか検証しました。検証で見つかった情報の不足や参照権限を見直し、調査処理を改善しています。
Markshipの担当範囲
- 既存の監視・通知運用を踏まえた一次調査フローの設計
- GitHub ActionsとClaude Agent SDKによる調査処理の実装
- AWSの情報収集、関連コードの参照、Slackへの結果返信の連携
- 参照権限、秘密情報の扱い、実行コマンドの制限
- 障害再現による検証と、既存案件への組込み