AI駆動開発を支えるハーネスの設計と実践
AIの作業を支える指示・検査・レビューなどの仕組み「ハーネス」を設計。Claude Codeによる実装とCodexによるレビューを組み合わせ、人が要件や使いやすさの判断に時間を使える開発を目指した自社の実践です。
対象: 自社で実践するAIを用いた開発プロセス
担当範囲: 開発フロー、指示書・スキル、自動検査、別モデルによるレビュー、並行作業環境の設計と改善
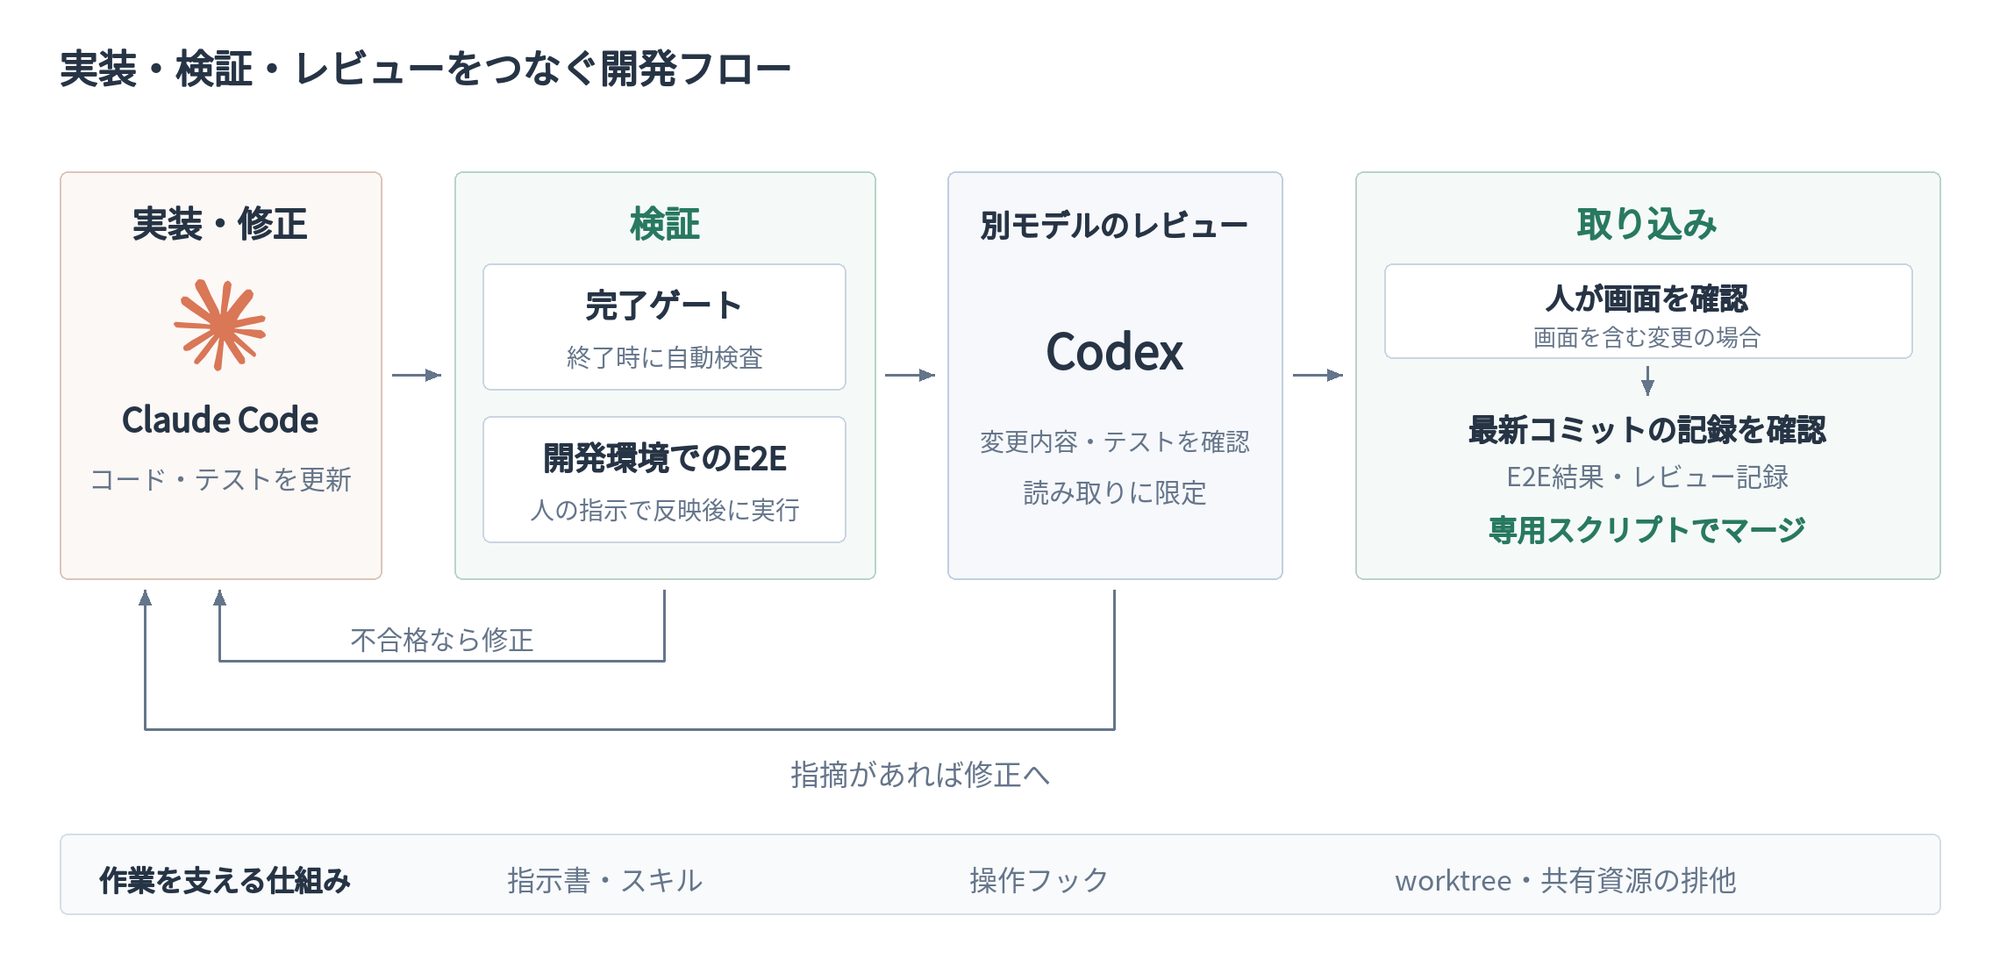
実装から変更の取り込み(マージ)までの主な流れ。計画の承認や設計判断は、この前段や作業途中に行います。
AIに任せる範囲と、確認の仕組みを整える
AIに実装を任せても、テストやレビューが済んでいるか、別の作業の変更が混ざっていないかを、人が毎回確認していては負担が残ります。指示を詳しくするだけでなく、作業の進め方と確認条件を仕組みとして整えることが必要でした。
AIによる開発支援ツールであるClaude Codeを実装役、OpenAIのCodexをレビュー役として使います。共通ルールを記した「指示書」、作業別の手順をまとめた「スキル」、特定の操作や終了時に処理を実行する「フック」に、自動検査を組み合わせて設計しました。
実践した運用では、AIに任せる範囲を次のように分けました。
| 作業 | 実行・判断の分担 |
|---|---|
| 計画・設計 | AIが案を作成し、人が承認・判断 |
| 実装・テスト・文書更新 | Claude Codeが実行 |
| 開発環境への反映 | 人が反映を指示し、AIが専用スクリプトで実行 |
| 画面変更の確認 | 人が開発環境で実物を確認し、取り込み可否を判断 |
| 変更の取り込み | AIが検証記録を確認する専用スクリプトでマージ |
| 本番への反映・環境の削除 | 人が実行 |
開発環境への反映を人が指示することは、運用上の約束です。一方、本番操作や破壊的な操作はフックでも制限します。人の判断に委ねる部分と、機械的に検査する部分を分けて設計しました。
指示書には共通の約束と参照先をまとめ、作業ごとの詳しい手順はスキルに分けています。必要な設計情報と手順を作業に応じて読み込ませ、長い指示を毎回渡す運用を避けました。
終了と取り込みを、検証結果に基づいて判断する
完了ゲートで自動検査する
中心となるのは、AIが作業を終えようとしたときに動く完了ゲートです。対象の変更を検出すると、Lint・型チェック・テストを自動で実行し、不合格なら完了報告を止め、AIへ結果を返して修正へ戻します。E2Eテストは、人の指示で開発環境へ変更を反映した後に実行し、修正内容が実際の操作の流れで期待どおりに動くかを確認します。完了ゲートとは別に実行し、結果を記録します。
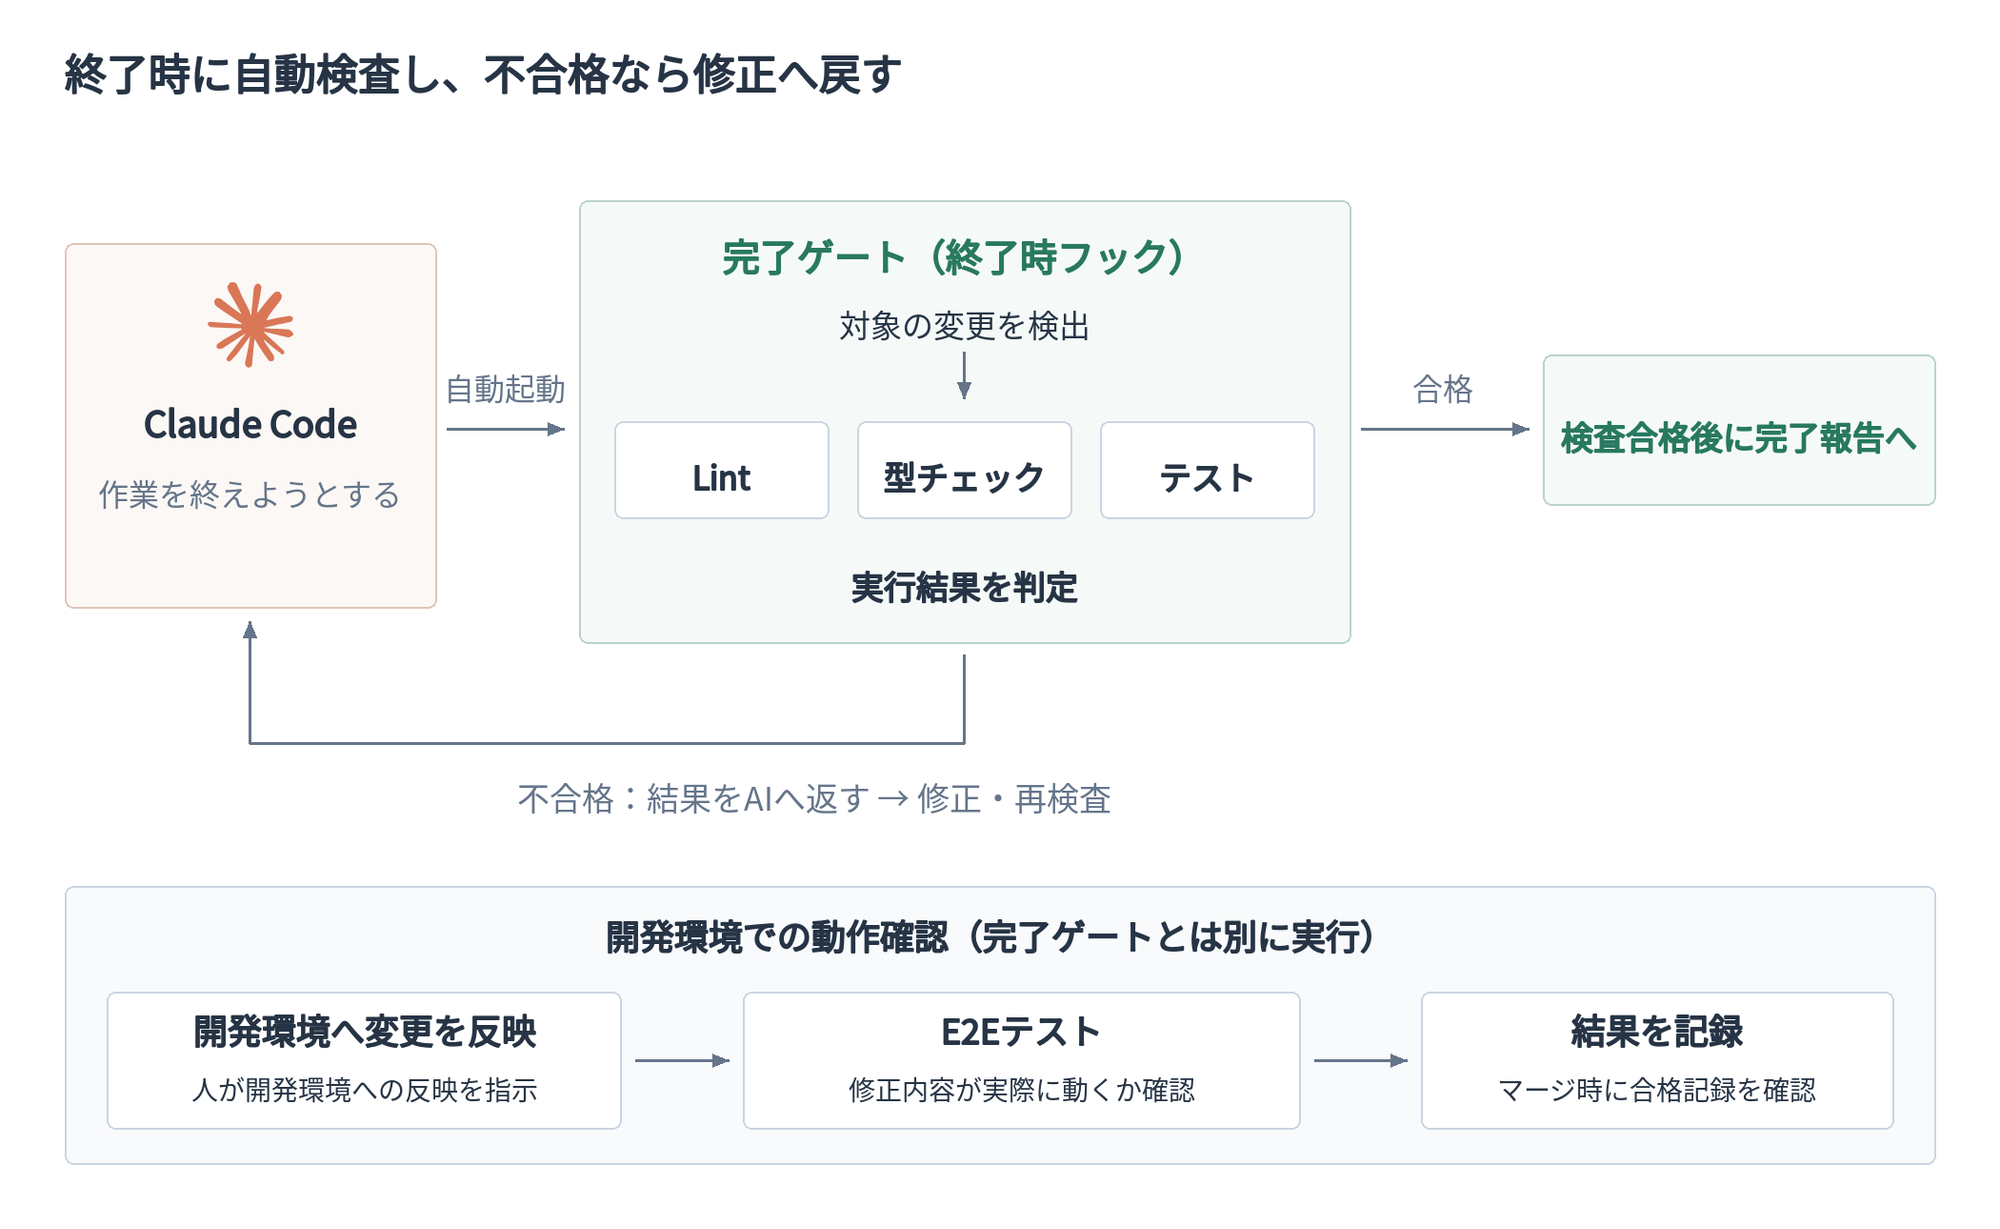
上段は対象変更の自動検査から完了報告まで、下段は開発環境へ反映した変更の動作確認を示します。
確認は最後にまとめず、操作前の制限、編集直後のLint、終了時の完了ゲート、マージ時の記録確認と段階を分けました。問題を見つけた時点でAIへ返し、後の工程へ持ち越しにくくする狙いです。
検査結果の読み違いを防ぐ
検査結果の読み違いにも対応しました。テストの出力をパイプで絞り込んだ際に、元のコマンドの失敗を見落とした経験から、その書き方をフックで禁止。ログはファイルに保存し、実行直後に終了コードを取得してから、保存ログを確認する手順にしました。
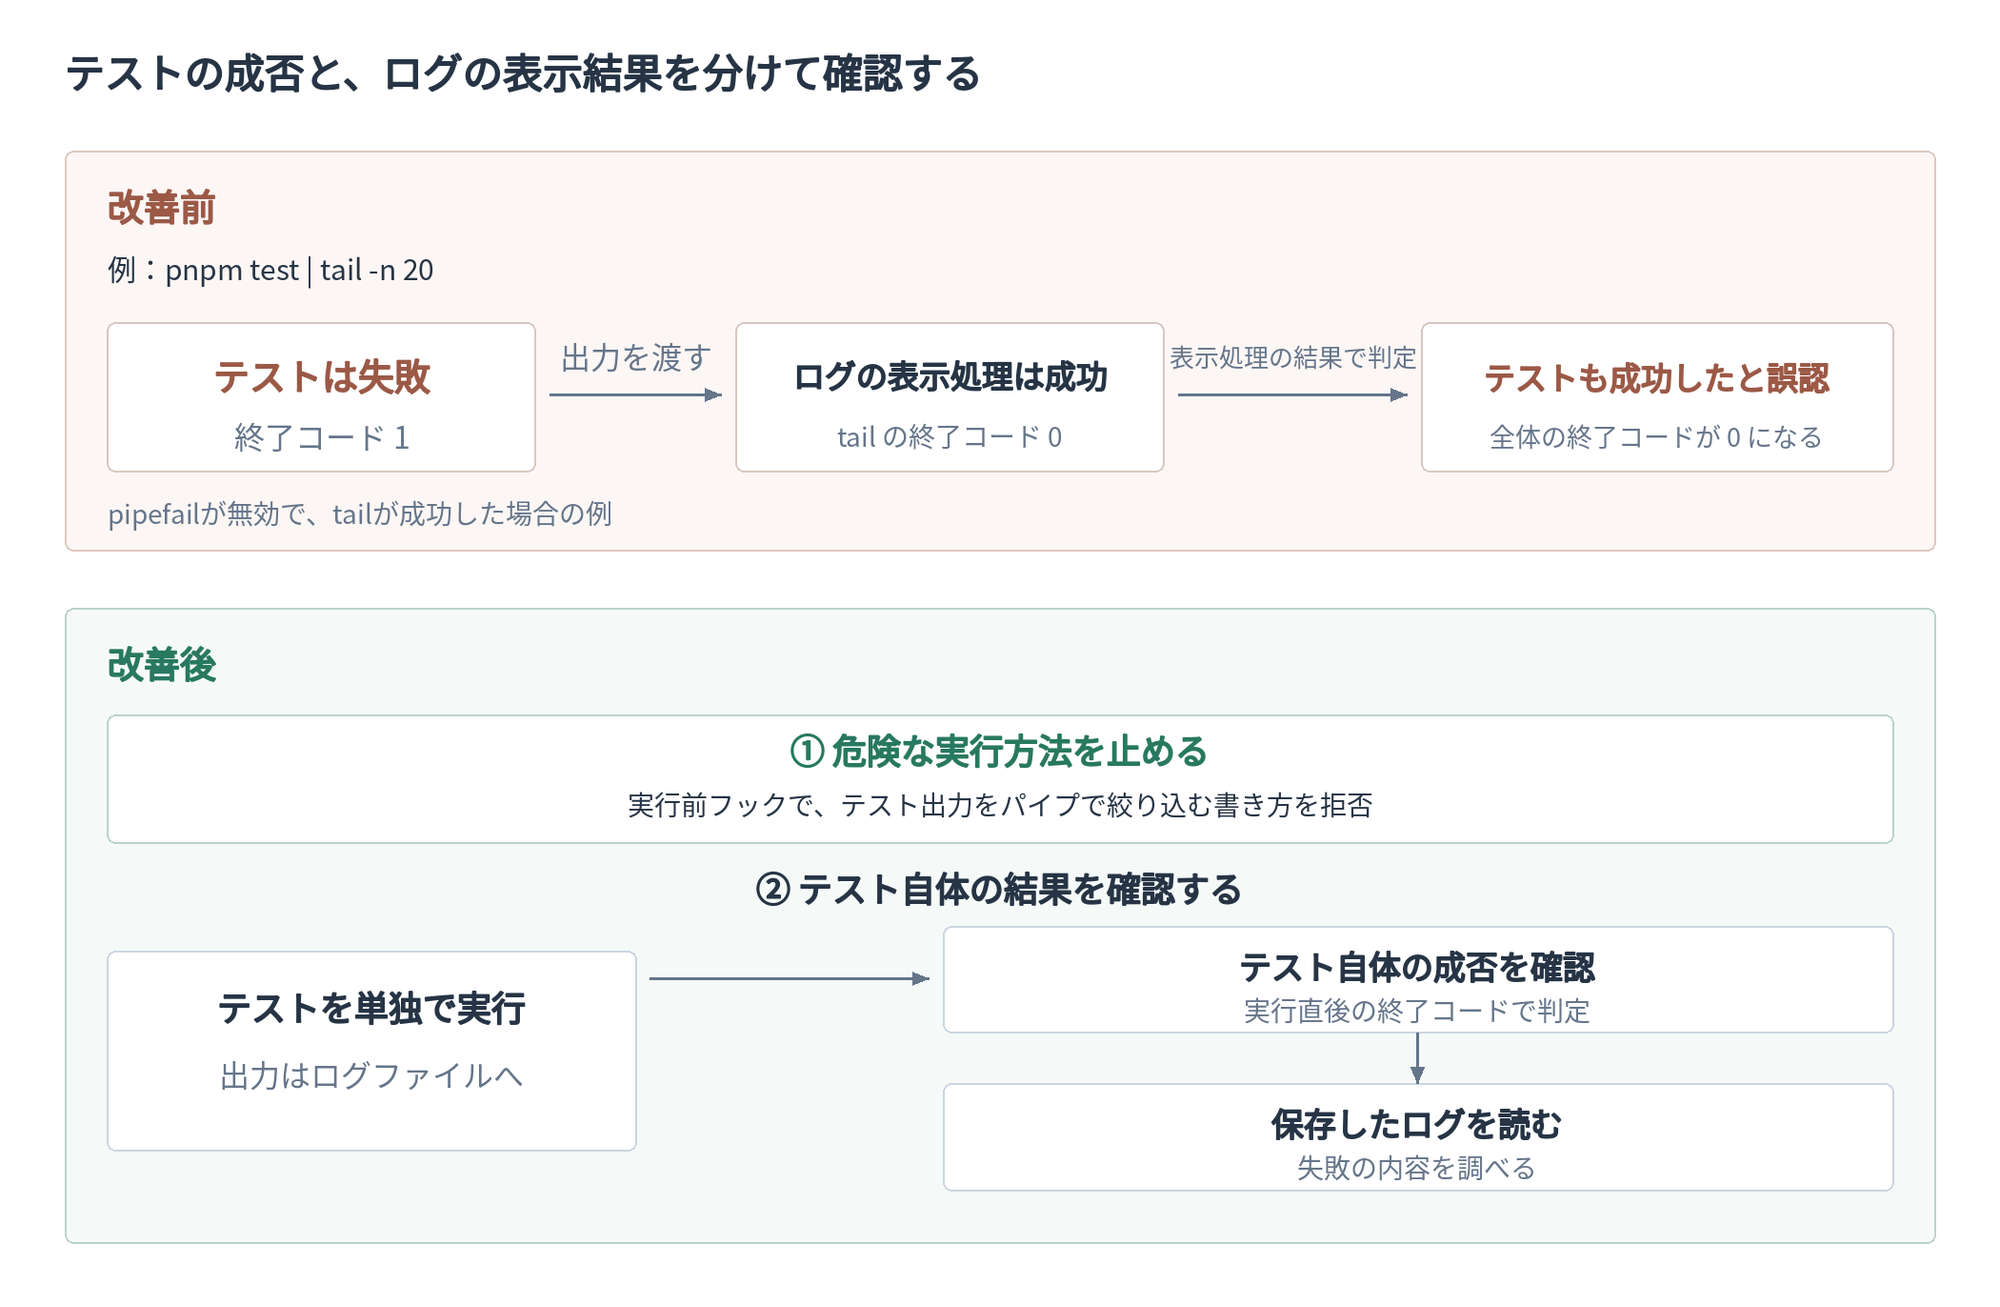
終了コードはテスト実行の直後に取得し、保存したログで失敗内容を調べます。コマンドは説明用の例です。
最新の検証記録を確認して取り込む
マージ用スクリプトは、最新コミットに対応するE2Eの合格記録とレビュー記録を確認します。修正前の古い合格記録を、修正後の変更の検証済み扱いに流用しないためです。レビュー指摘を受けて修正した場合は、再検証し、レビュー記録も更新します。画面を含む変更では、人が開発環境で実物を確認してから取り込みます。
終了時の自動検査は、検出対象の変更を扱います。マージ時には、最新コミットに対応するE2Eの合格記録とレビュー記録を機械的に確認し、変更内容の妥当性はレビューと人の確認で判断します。
別モデルで設計と実装を問い直す
レビューは設計段階と実装後の両方で行い、確認する対象と観点を分けています。
| 設計段階のレビュー | 実装後のレビュー | |
|---|---|---|
| 対象 | 前提・設計案・選択肢 | コード・テスト・仕様との対応 |
| 確かめること | 見落とした条件や設計上の弱点 | 実装の問題や必要なテストの不足 |
| 指摘への対応 | 設計案を見直す | 実装を修正し、再検証する |
重要な設計判断では、別モデルに前提や選択肢の弱点を積極的に指摘させる「敵対的レビュー」を行います。テスト方針や並行作業の分離、ハーネス自体の設計も対象にしました。
実装後は、仕様の項目と確認方法を対応付けた表もレビュー対象にします。単体テスト・E2E・人手確認の選び方を問い直し、テストが通るかだけでなく、必要なことを確かめるテストになっているかを確認します。
コードの変更は、操作フックを配置したClaude Code側で行い、Codexは読み取りと指摘に役割を限定しています。レビューで問題が見つかった場合も、実装役が修正し、検証をやり直す流れに揃えました。
並行作業を分離し、失敗を仕組みの改善につなげる
作業場所と共有資源の競合を防ぐ
複数のAIセッションが同じ作業場所を使うと、別の作業の変更をコミットへ巻き込むことがあります。当初はステージするファイルや分岐元を明示する約束で対処していましたが、約束だけでは変更の巻き込みを防げなかったため、コードを変更する作業ではgit worktreeで作業場所を分ける運用に変えました。
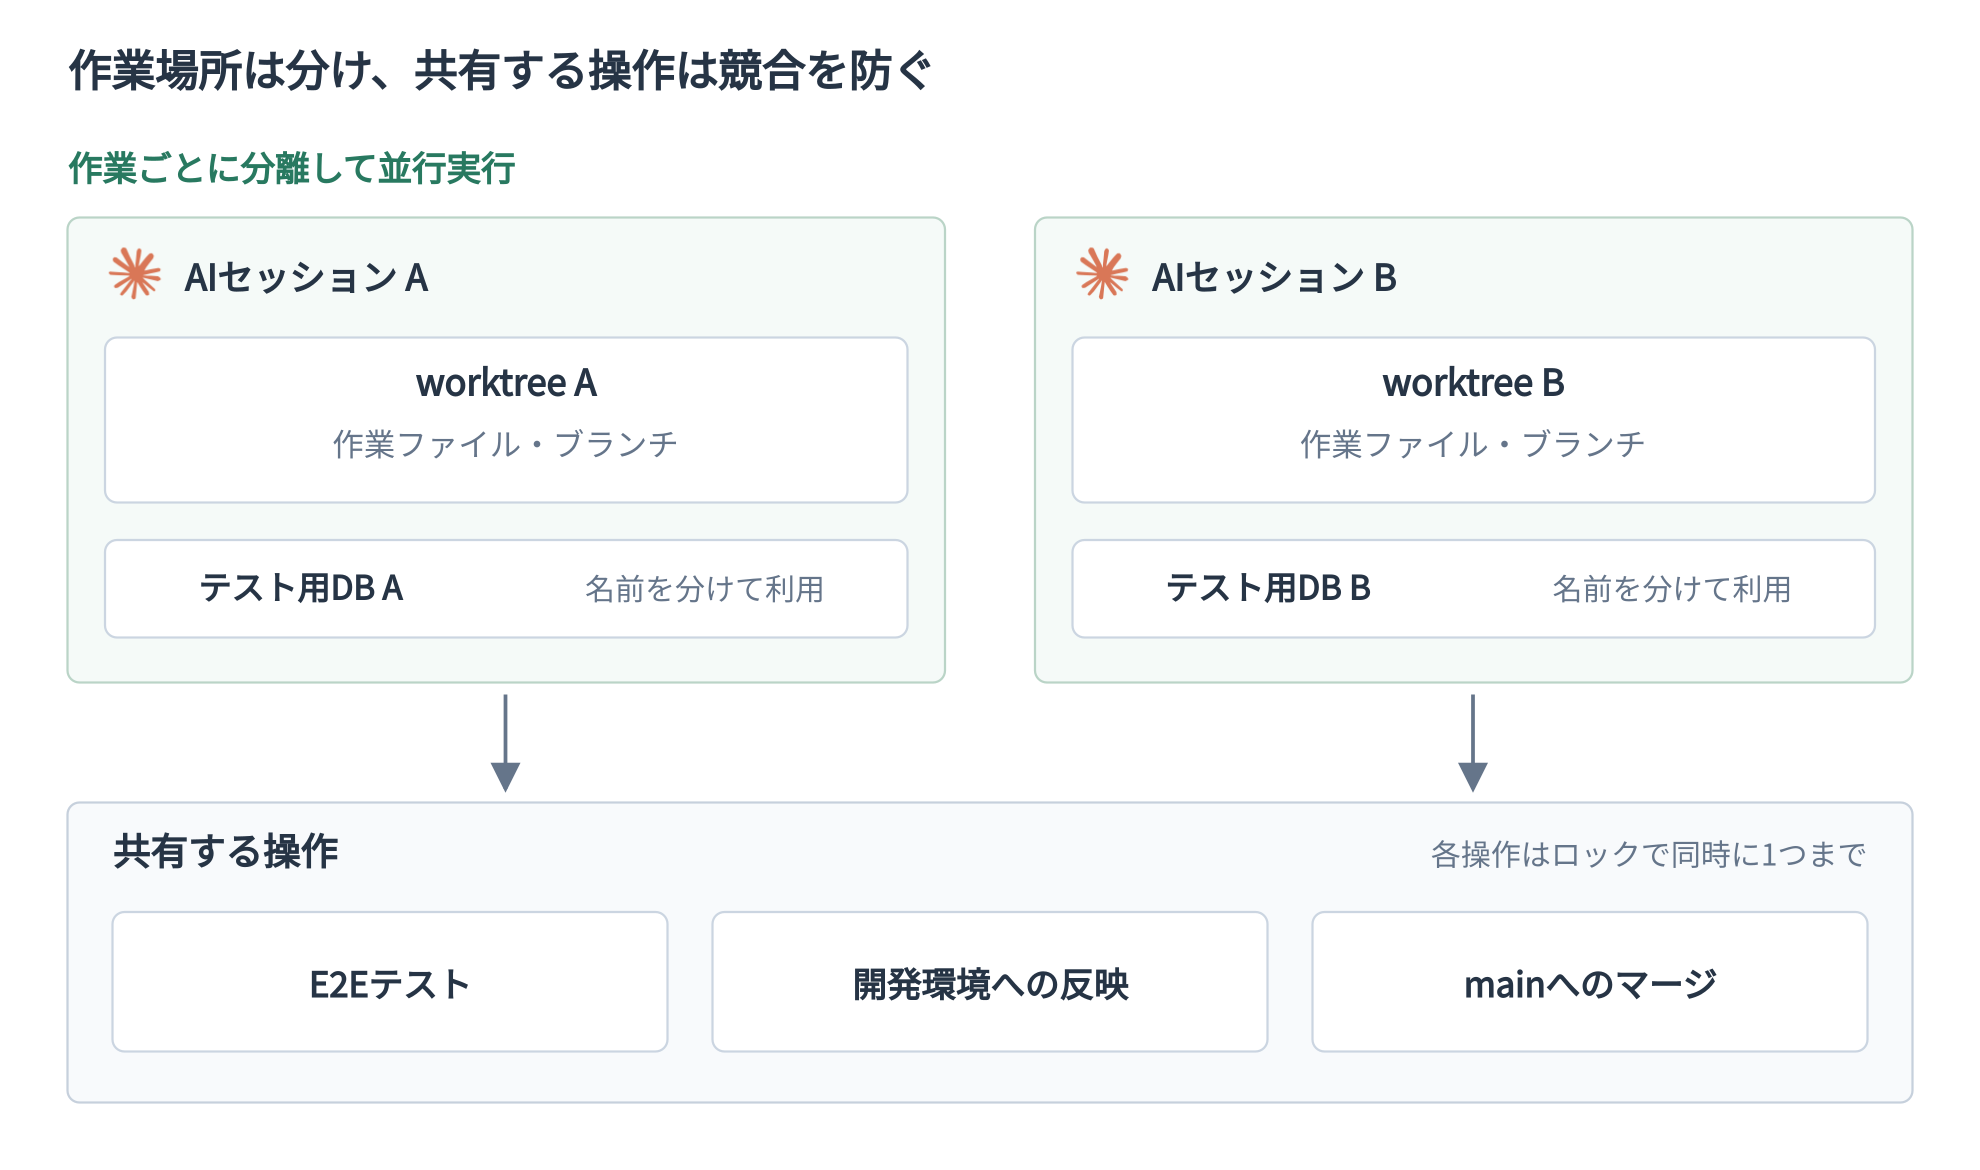
ロックは操作ごとに設け、同じ共有操作の同時実行を防ぎます。
ただし、作業ファイルを分けても、テスト用DBや開発環境などの共有資源は残ります。テスト用DBは作業場所ごとに名前を分け、E2Eや環境への反映、マージはロックで同時実行を防ぐ構成にしました。
開発サーバーは、指定したポートが使用中なら別のポートへ移らず、起動を失敗させます。画面確認が固定のポートへ接続した際に、別のworktreeの画面を撮影し、自分の変更を確認できたと誤認するのを防ぐためです。
失敗を再発防止の仕組みに変える
失敗が起きたときは、同じ種類の失敗を防ぐ手当てを加えてから作業を閉じる方針です。まずLintルールやテストなどの検査を検討し、機械では扱いにくい判断をスキルや指示書へ残します。注意事項を増やすだけでなく、作業の構造や検査を変え、意図した条件で検出・停止することを確認してきました。
人が要件と使いやすさの判断に時間を使う
運用する中で、作業ミスの検出や別モデルによるレビューを組み込んだことで、人が技術的な確認を繰り返す負担が減ったと感じています。考慮漏れや設計上の懸念を早めに確認でき、業務上の要望を満たしているか、使いやすいかの判断に、より時間を使えるようになりました。
画面についてもAIが一次の確認と所見を出し、人が実物を触って採否を判断します。人の確認をなくすのではなく、確認する内容の重点を変える取り組みです。効果は運用を通じた実感であり、開発全体の工数削減率や品質改善率を測定したものではありません。
この開発フローと別モデルによるレビューの仕組みは、社内の検証用アプリケーション開発にも転用しています。AIに任せる範囲と確認条件を調整しながら、開発手法として改善を続けています。